Tutorial P2P- vollständiges Basismodell laden und verstehen
TL;DR
Ziel: Vom manuell aufgebauten Übungsmodell auf das vollständige Simple-P2P-Basismodell wechseln.
Voraussetzungen: Die grundlegende Tabellen-, Freigabe- und 1:N-Logik aus den vorherigen Artikeln ist verstanden.
Ergebnis:Config 1 – Basisist geladen und bildet den Ausgangspunkt für alle folgenden fachlichen Use Cases.
Warum wechseln wir jetzt auf eine vorbereitete Config?
In den bisherigen Schritten haben wir bewusst nur einen Ausschnitt des P2P-Modells selbst aufgebaut.
Dadurch konnten wir die wichtigsten Grundlagen nachvollziehen:
- Tabellen und Primary Keys,
- Foreign Keys,
- Primary und zusätzliche Timestamps,
- die kausale Kette
Causal Chain, - Branches und Joins,
- sowie die 1:N-Beziehung zwischen
bestellungundbestellposition.
Für die folgenden Use Cases benötigen wir nun jedoch einen umfangreicheren Datensatz.
Maverick Buying benötigt beispielsweise Informationen zum anforderer. Lieferantenperformance benötigt einen lieferant. Skontoverlust benötigt Rechnungs-, Freigabe- und Zahlungsinformationen.
Anstatt all diese Tabellen und Attribute einzeln manuell anzulegen, wechseln wir jetzt auf einen definierten Ausgangszustand.
1. Config 1 – Basis laden
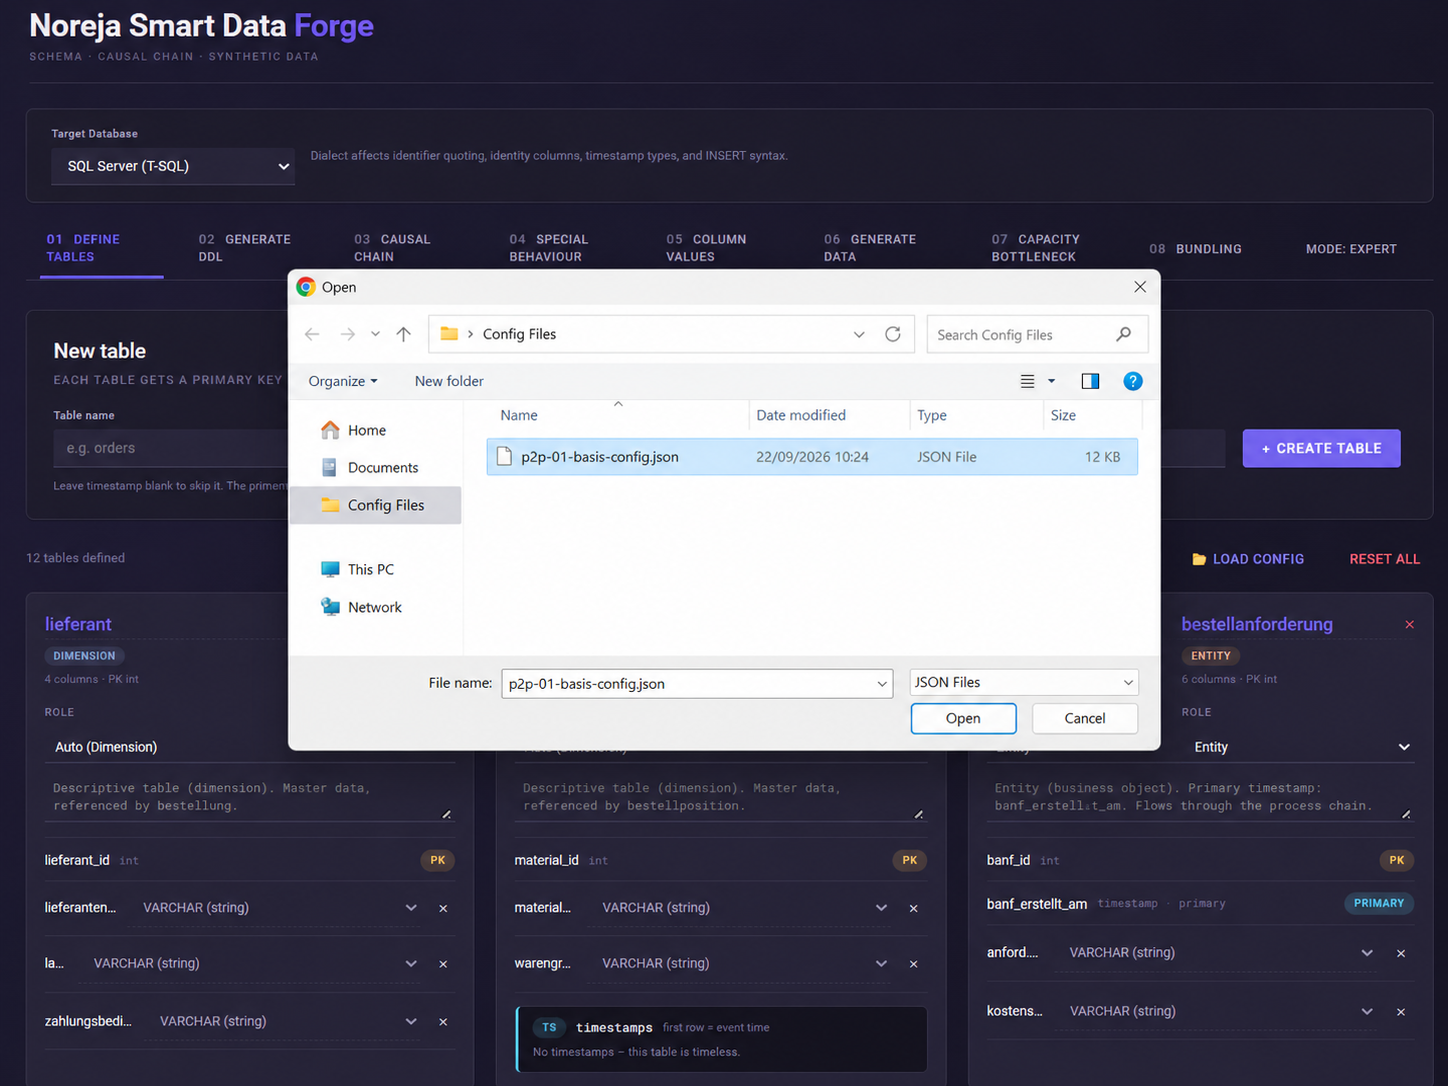
Verwende: Load config und wähle: p2p-01-basis-config.json
Wichtig: Load config ergänzt den bestehenden Zustand nicht.
Die geladene Config ersetzt den aktuellen Arbeitsstand vollständig. Tabellen, Slots, Column Values, Run Settings und alle weiteren gespeicherten Einstellungen werden aus der Config übernommen.
Der zuvor manuell aufgebaute Stand wird damit bewusst verlassen.
Was enthält die Basis-Config?
Nach dem Laden stehen zwölf Tabellen zur Verfügung:
Referenz- und Stammdaten
lieferant, material, vertrag
Diese Objekte bilden fachliche Informationen ab, die von den eigentlichen Prozessobjekten referenziert werden.
Sie sind nicht als eigene Prozessschritte in der kausalen Kette Causal Chain platziert, sondern werden als Stammdaten Reference data erzeugt.
Prozessobjekte
bestellanforderung, freigabe_a, freigabe_b, bestellung, bestellposition, wareneingang, rechnung, rechnung_freigabe, zahlung
Damit besitzen wir nun einen vollständigen vereinfachten P2P-Prozess von der Anforderung bis zur Zahlung.
Die Prozesskette der Basis-Config
Unter 03 Causal Chain findest du nun folgende fachliche Grundstruktur:
bestellanforderung
→ Freigabelogik: Direct XOR Dual (freigabe(n))
→ bestellung
→ bestellposition
→ wareneingang
→ rechnung
→ rechnung_freigabe
→ zahlung
Die bereits kennengelernte Freigabestruktur bleibt erhalten.
Auch die Beziehung:
bestellung → bestellposition
ist weiterhin mit einer Kardinalität von 1 bis 3 Bestellpositionen und skew low modelliert.
Warum fehlen Lieferung und Warenprüfung?
Das Basismodell ist bewusst noch nicht das vollständige Expert-Modell.
Objekte wie:
lieferung
warenannahme
bereitstellung
wareneingang_pruefung
kommen erst später hinzu.
Sie werden benötigt, wenn wir unterschiedliche Beschaffungspfade sowie Capacity Bottlenecks und Delay Propagation untersuchen.
Für die ersten fachlichen Use Cases würde diese zusätzliche Struktur den Einstieg unnötig komplex machen.
Deshalb arbeiten wir zunächst mit einer vereinfachten Kette:
bestellposition → wareneingang → rechnung
Erst im Expert Mode wird daraus ein differenzierterer Prozess.
Noch eine saubere Welt
Ein besonders wichtiger Punkt der Basis-Config:
Es sind noch keine fachlichen Prozessabweichungen konfiguriert.
Unter 04 Special Behaviour existieren zunächst keine Regeln.
Es gibt also noch kein:
- Maverick Buying,
- Rework,
- Wrong Order,
- oder bewusst erzeugten Prozessabbruch.
Auch die Conditional Rules, mit denen wir später beispielsweise Lieferantenperformance oder Working-Capital-Effekte modellieren, sind noch bewusst leer.
Column Values sind bereits vorbereitet
Obwohl noch keine Prozessabweichungen vorhanden sind, enthält die Basis-Config bereits Wertkonfigurationen für die fachlichen Attribute.
Dadurch müssen wir beispielsweise Lieferantennamen, Anforderer, Produktgruppen, Beträge oder andere Basiswerte nicht für jeden Artikel neu konfigurieren.
Die Trennung ist wichtig:
Column Values bestimmen, welche Werte in den Daten vorkommen.
Special Behaviour und Conditional Rules bestimmen, wie sich bestimmte Cases oder Werte auf den Prozess auswirken.
Ein Lieferant namens Globex SE ist damit zunächst einfach nur ein Lieferant.
Er wird erst dann zu unserem Beispiel für schlechte Lieferantenperformance, wenn wir später eine Regel hinzufügen, die für diesen Lieferanten längere Prozesszeiten verursacht.
Reference Data
Unter Causal Chain → Reference data findest du die Tabellen, die nicht selbst als Prozessschritt verwendet werden.
In unserer Basis sind insbesondere:
lieferant , material, vertrag
solche Referenzobjekte.
Die Config erzeugt davon eine definierte Anzahl von Datensätzen. Prozessobjekte können anschließend über ihre Foreign Keys auf diese Stammdaten verweisen.
Das ermöglicht später Analysen wie:
- Durchlaufzeit nach Lieferant,
- Prozessverhalten nach Material,
- Bestellungen mit oder ohne Vertragsbezug.
Die Stammdaten werden also nicht selbst zu Prozessaktivitäten, liefern aber wichtige Analyse-Dimensionen.
Run Settings prüfen
Die Tutorial-Config verwendet weiterhin:
| Einstellung | Wert |
|---|---|
| Number of cases | 500 |
| Start date | 2025-01-01 |
| Span (days) | 90 |
| Seed | 42 |
| Target Database | SQL Server |
| Mode | Simple |
Der Seed bleibt während des Trainings gleich.
Dadurch können wir die Auswirkungen unserer Änderungen besser vergleichen: Unterschiede zwischen zwei Läufen entstehen nicht nur durch eine komplett neue zufällige Grundgesamtheit, sondern primär durch die Regeln, die wir hinzufügen.
Unser Ausgangspunkt für die nächsten Artikel
Ab jetzt bauen alle Simple-Artikel auf diesem Stand auf.
Wir laden die Basis-Config also nicht vor jedem Artikel erneut.
Stattdessen erweitern wir dasselbe Modell nacheinander:
Basis
→ Maverick Buying
→ schlechte Lieferantenperformance
→ Bestelländerung / Rework
→ Wrong Order
→ Prozessabbruch / offene Prozesse
→ Working Capital und Skontoverlust
Nach dem letzten Schritt entspricht unser selbst aufgebauter Stand fachlich:
Config 2 – Simple
Diese zweite Config dient als Referenz, falls ein Zwischenstand verloren geht oder das eigene Ergebnis überprüft werden soll.
Save config kann zwischendurch jederzeit verwendet werden, ist für jeden einzelnen Artikel aber nicht erforderlich.
Was wir jetzt bewusst noch nicht machen
Wir konfigurieren noch keine:
Capacity Bottleneck-Regeln,
- Backlogs,
- Delay Propagation,
- Bundling-Läufe,
- Physical-/Software-Prozesspfade.
Diese Funktionen behandeln wir gesammelt im späteren Expert-Teil.
Nächster Schritt: Maverick Buying
Unser erstes fachliches Szenario lautet:
Werden Bestellungen ohne die eigentlich vorgesehene Freigabe durchgeführt?
Dafür verwenden wir die bereits vorhandene Freigabestruktur und ergänzen erstmals ein Special Behaviour.
Bestimmte Anforderer werden gezielt den eigentlich vorgesehenen Freigabeweg umgehen.
Dabei lernen wir auch eine wichtige Unterscheidung kennen:
Ein regulärer DIRECT-Pfad ist eine vorgesehene Prozessvariante.
Maverick Buying ist dagegen eine gezielt erzeugte Abweichung vom erwarteten Freigabeverhalten.
Im nächsten Artikel konfigurieren wir genau diesen Unterschied mit Team bypass.