Noreja Smart Data Forge
TL;DR
Die Noreja Smart Data Forge ist ein Generator für synthetische Prozessdaten. Sie wird verwendet, um realistische Datensätze für Process Mining und insbesondere für die Analyse kausaler Prozesszusammenhänge zu erzeugen.Sie kommt vor allem dann zum Einsatz, wenn für einen Kundenprozess noch keine geeigneten Daten verfügbar sind, reale Daten aus Datenschutz- oder Vertraulichkeitsgründen nicht verwendet werden dürfen oder gezielt bestimmte Prozesssituationen für Tests und Demonstrationen erzeugt werden sollen.
Grundprinzip
Die Smart Data Forge erzeugt nicht nur ein klassisches Event Log. Stattdessen wird zunächst die zugrunde liegende Datenbankstruktur des Prozesses modelliert.
Tabellen, Primär- und Fremdschlüssel, Zeitstempel und weitere Attribute werden so angelegt, dass Beziehungen zwischen den verschiedenen Geschäftsobjekten erhalten bleiben. Auf dieser Grundlage wird anschließend definiert, wie sich die Objekte im Prozess gegenseitig bedingen und in welcher zeitlichen Reihenfolge sie entstehen.
Dadurch können synthetische Daten erzeugt werden, die sowohl die Struktur eines realen Quellsystems als auch das Verhalten eines realen Geschäftsprozesses abbilden.
Die Smart Data Forge unterstützt derzeit PostgreSQL, SQL Server, MySQL und Oracle. Der ausgewählte Datenbanktyp beeinflusst unter anderem Datentypen, Identifier, Identity-Spalten und die erzeugte SQL-Syntax.
Typischer Workflow
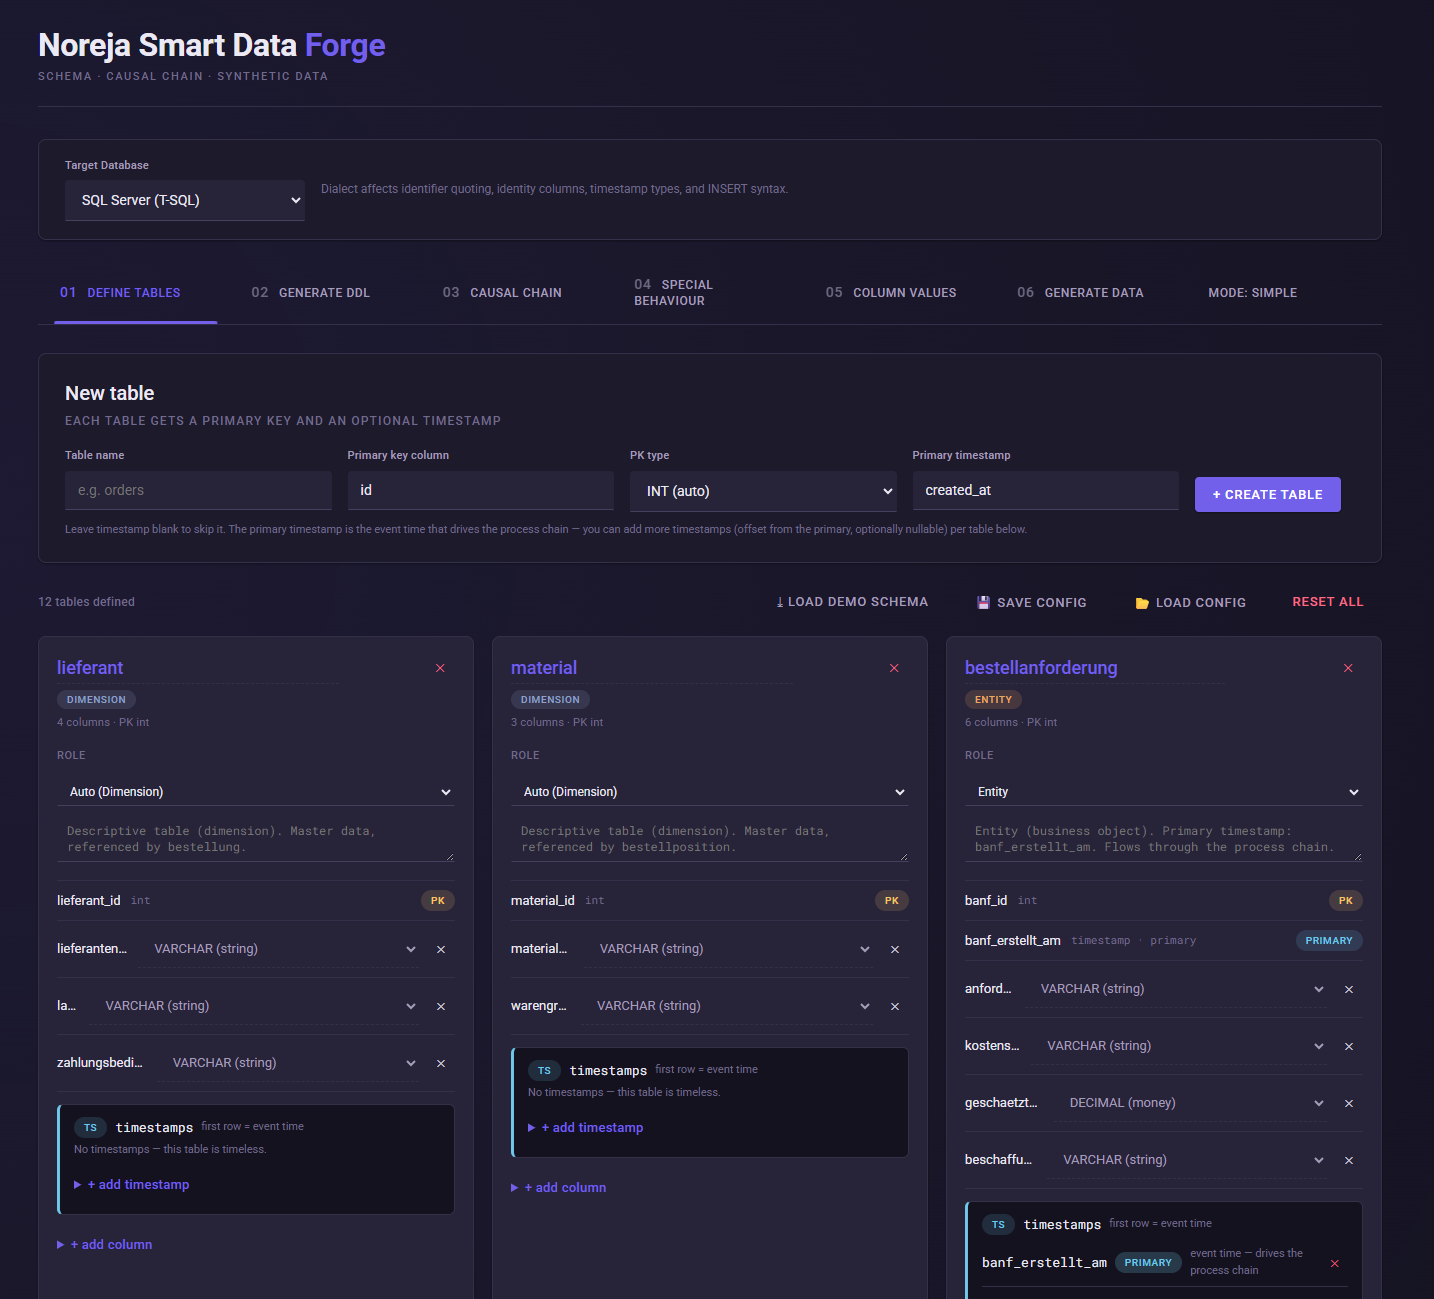
1. Tabellen und Entitäten definieren
Unter Define Tables wird zunächst das Datenmodell des Prozesses aufgebaut.
Für jede Tabelle können unter anderem Tabellenname, Primärschlüssel, Datentyp des Primärschlüssels und Zeitstempel definiert werden. Anschließend lassen sich weitere Attribute und Fremdschlüssel ergänzen.
Tabellen können unterschiedliche Funktionen innerhalb des Datenmodells übernehmen, beispielsweise Geschäftsobjekte, historische Tabellen beziehungsweise Aktivitätsverläufe oder Stammdaten.
Nicht jede Tabelle benötigt zwingend einen Zeitstempel. Reine Stammdaten- oder Dimensionstabellen können zeitlos sein. Für prozessrelevante Geschäftsobjekte wird dagegen mindestens ein Prozesszeitstempel benötigt.
Eine Tabelle kann außerdem mehrere Zeitstempel enthalten. Der primäre Zeitstempel bestimmt den Zeitpunkt des Objekts innerhalb der Prozesskette. Weitere Zeitstempel können relativ dazu erzeugt werden, beispielsweise für Versand, Freigabe oder Abschluss eines Vorgangs.
Für Tabellen, die mehrere Aktivitäten eines Geschäftsobjekts enthalten, kann eine Status-Spalte verwendet werden. Die verschiedenen Statuswerte werden dabei als aufeinanderfolgende Prozessaktivitäten interpretiert. Für die Übergänge zwischen diesen Aktivitäten lassen sich eigene Zeitabstände und Abbruchwahrscheinlichkeiten konfigurieren.
2. SQL-Datenmodell erzeugen
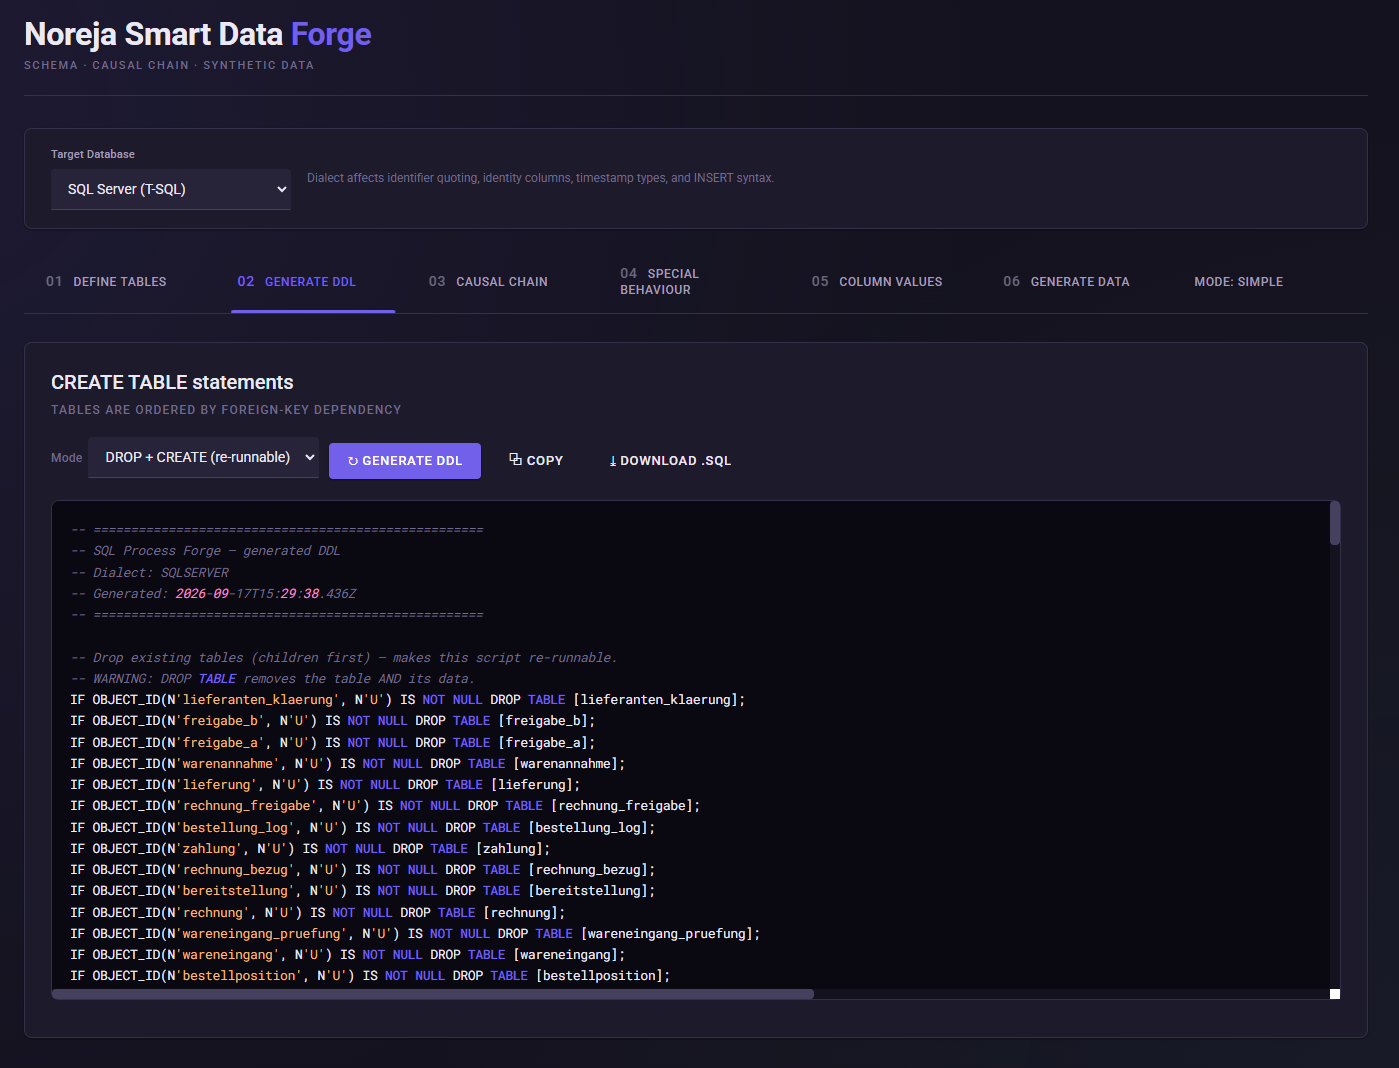
Unter Generate DDL erzeugt die Smart Data Forge die SQL-Struktur für das definierte Datenmodell.
Dabei werden Tabellen entsprechend ihrer Fremdschlüsselabhängigkeiten in die richtige Reihenfolge gebracht. Das erzeugte SQL kann kopiert oder als SQL-Datei heruntergeladen werden.
Optional kann ein wiederholt ausführbarer (DROP+CREATE) Modus verwendet werden, bei dem bestehende Tabellen zunächst entfernt und anschließend neu angelegt werden.
3. Kausale Prozesskette definieren
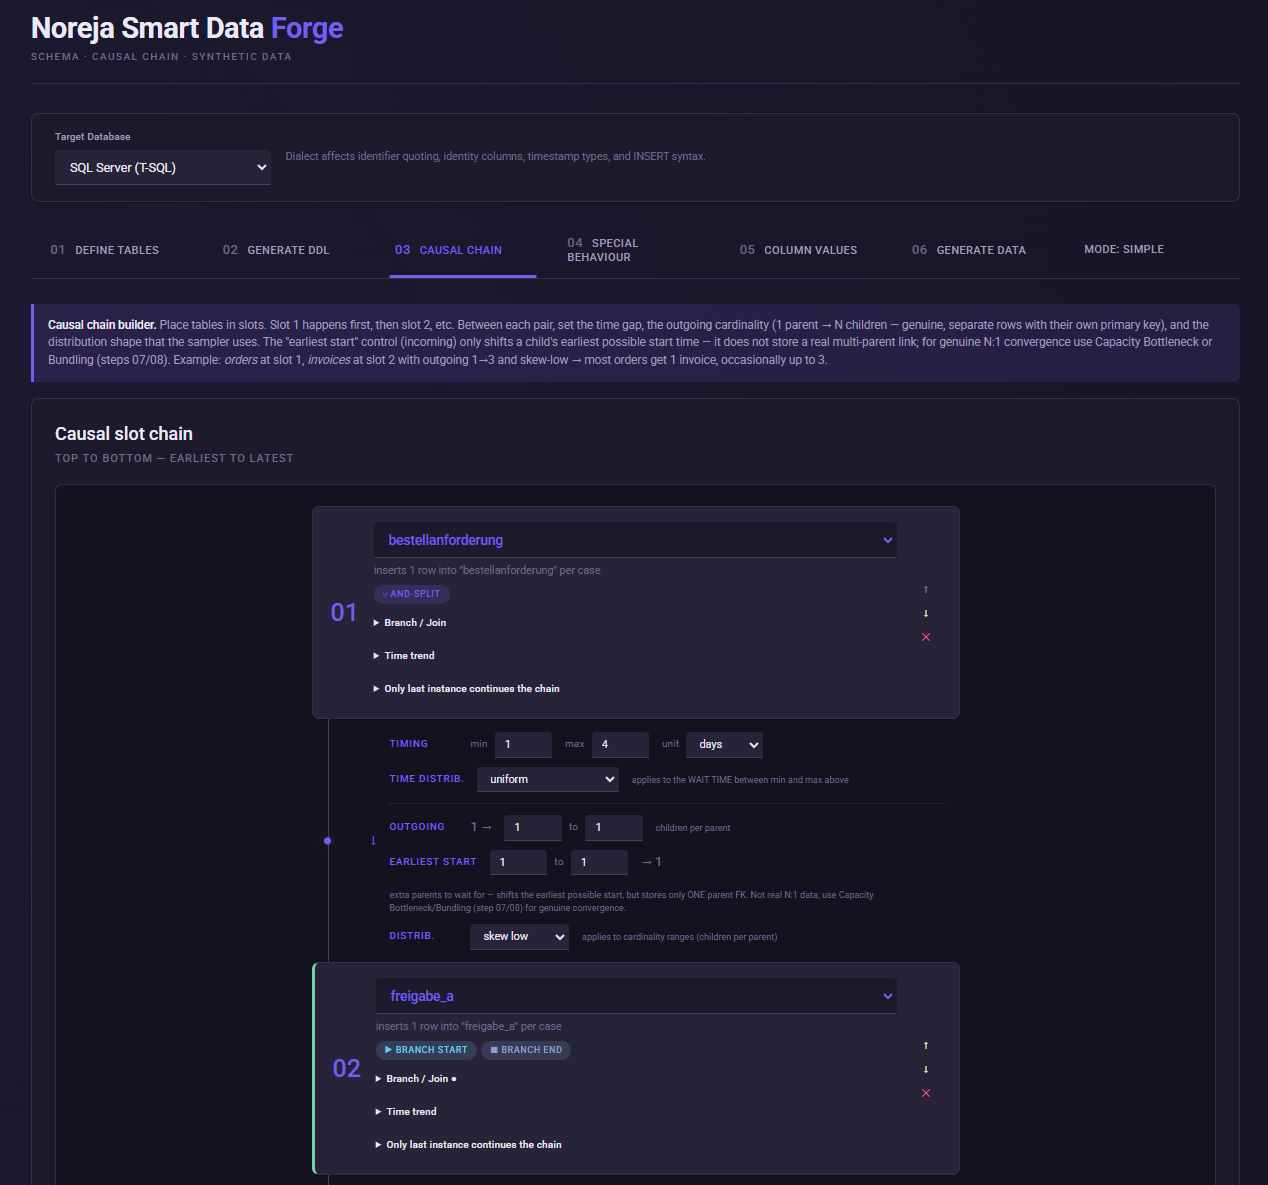
Unter Causal Chain wird festgelegt, wie die zuvor definierten Tabellen im Prozess miteinander zusammenhängen.
Dazu werden Tabellen in Prozess-Slots eingeordnet. Die Reihenfolge der Slots beschreibt zunächst die kausale Abfolge des Prozesses.
Zwischen zwei Prozessschritten können Zeitabstände definiert werden. Zusätzlich lässt sich festlegen, wie viele nachfolgende Objekte aus einem Objekt entstehen können. Dadurch können beispielsweise 1 wie „eine Bestellung erzeugt mehrere Bestellpositionen“ simuliert werden.
Für Zeitabstände und Kardinalitäten stehen verschiedene Verteilungen zur Verfügung, sodass die generierten Prozesse nicht ausschließlich aus identischen Abläufen bestehen.
Neben einfachen linearen Abläufen können auch komplexere Prozessstrukturen mit Verzweigungen und Zusammenführungen modelliert werden. Dazu gehören unter anderem AND- und XOR-Verzweigungen sowie Joins. Für XOR-Pfade können unterschiedliche Wahrscheinlichkeiten hinterlegt werden.
In den Run Settings wird außerdem festgelegt, wie viele Cases erzeugt werden sollen, an welchem Datum die Simulation beginnt und über welchen Zeitraum die Cases verteilt werden. Optional kann ein Seed angegeben werden, um dieselbe Zufallsverteilung reproduzierbar erneut zu erzeugen.
Tabellen, die nicht Bestandteil der eigentlichen Prozesskette sind, können als eigenständige Referenz- oder Stammdaten erzeugt werden.
4. Prozessabweichungen modellieren
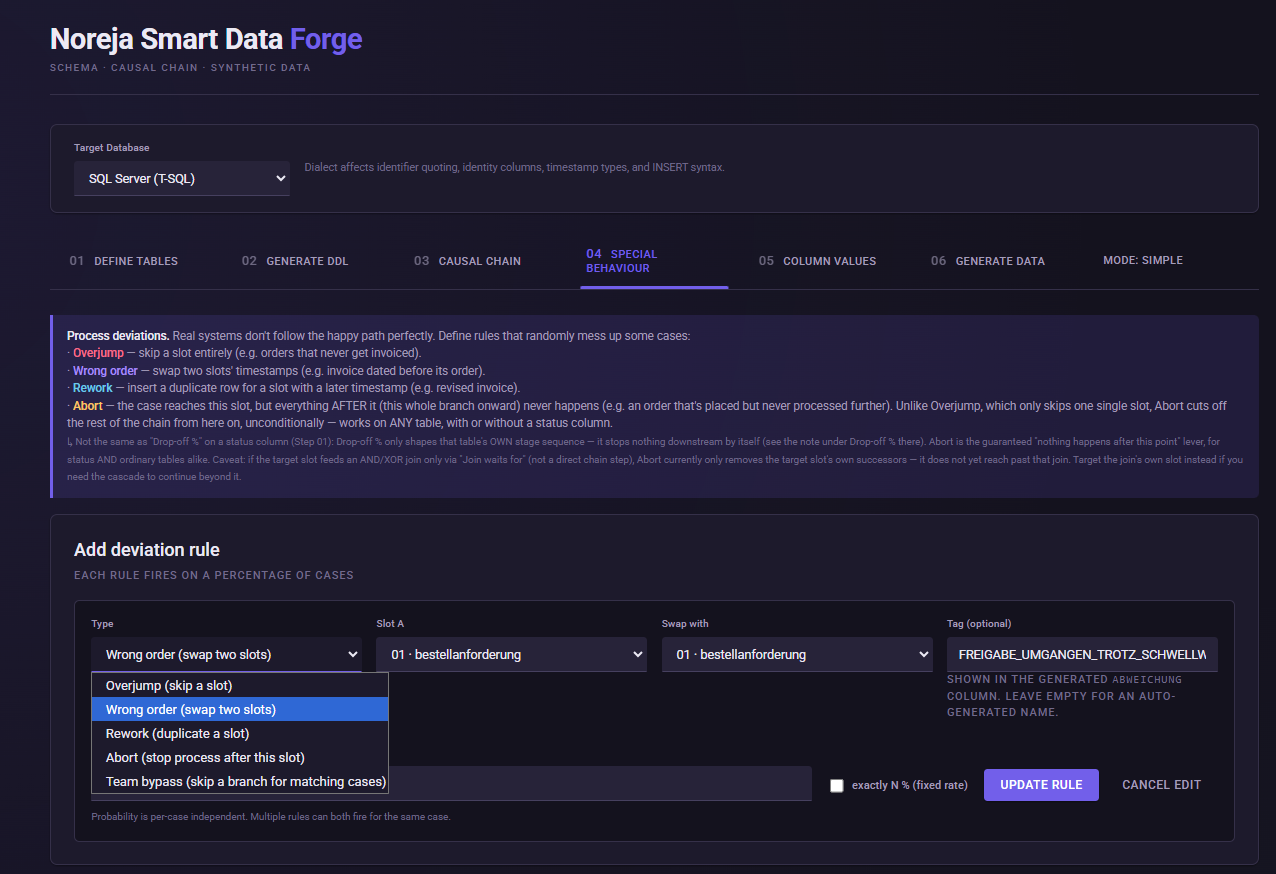
Unter Special Behaviour können gezielt Abweichungen vom regulären Prozess erzeugt werden.
Damit lassen sich unter anderem übersprungene Aktivitäten (Overjump), Aktivitäten in falscher zeitlicher Reihenfolge (Wrong Order), wiederholte beziehungsweise erneut ausgeführte Aktivitäten (Rework) und vorzeitig abgebrochene Prozesse (Abort) modellieren.
Zusätzlich können bestimmte Prozesspfade abhängig von Attributwerten übersprungen werden.
Für eine Abweichung wird festgelegt, bei welchem Prozessschritt sie auftreten soll und für welchen Anteil der Cases sie gelten soll. Dabei kann entweder eine Wahrscheinlichkeit verwendet oder ein fester Anteil der erzeugten Cases vorgegeben werden.
Mehrere Abweichungsregeln können gleichzeitig auf denselben Case wirken.
Zusätzlich unterstützt die Smart Data Forge bedingte Regeln. Damit kann das Verhalten eines Prozesses von erzeugten Attributwerten abhängig gemacht werden. Eine Bedingung kann beispielsweise die Bearbeitungszeit verändern, die Wahrscheinlichkeit einer Prozessabweichung beeinflussen oder einen bestimmten Attributwert setzen.
Auf diese Weise lassen sich nicht nur zufällige Abweichungen erzeugen, sondern auch fachlich begründete Zusammenhänge zwischen Prozessdaten und Prozessverhalten modellieren.
5. Attributwerte konfigurieren
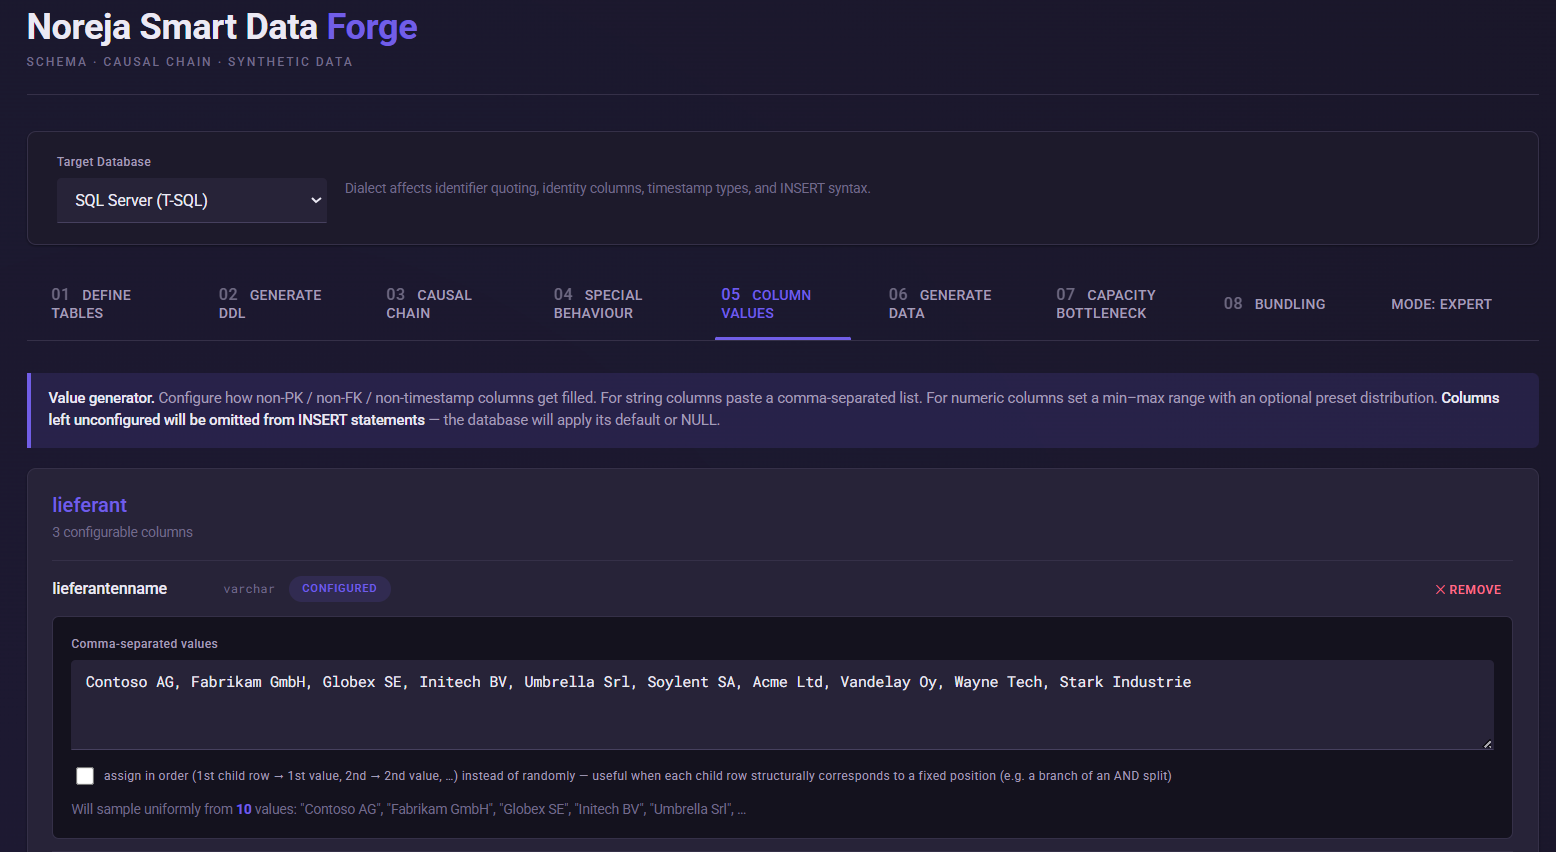
Unter Column Values wird festgelegt, welche Werte die fachlichen Attribute der erzeugten Datensätze erhalten.
Für Textattribute können beispielsweise konkrete Wertelisten hinterlegt werden. Werte können zufällig gezogen oder bei 1 in einer festen Reihenfolge vergeben werden.
Numerische Attribute können über Minimal- und Maximalwerte sowie unterschiedliche Verteilungen erzeugt werden. Für häufig verwendete Wertebereiche stehen Presets zur Verfügung.
Datumsfelder können innerhalb eines definierten Zeitraums erzeugt werden.
Spalten, für die keine Konfiguration vorgenommen wird, werden bei der Generierung nicht explizit befüllt. In diesem Fall kann die Datenbank beispielsweise einen Default-Wert oder NULL verwenden.
6. Synthetische Daten erzeugen
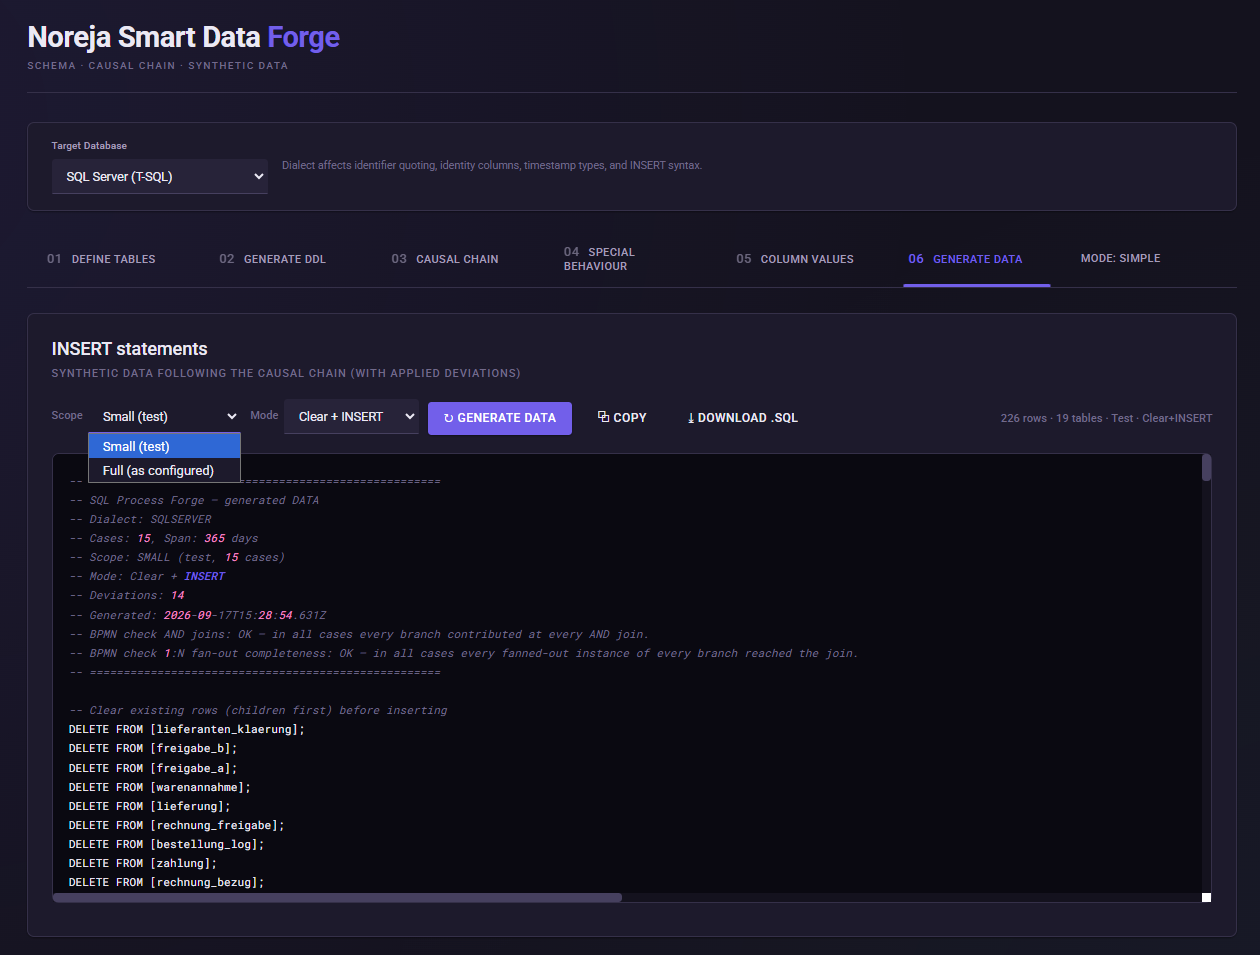
Unter Generate Data werden die synthetischen Datensätze auf Basis des Datenmodells, der kausalen Prozesskette, der Attributkonfigurationen und der definierten Abweichungen erzeugt.
Für Tests kann zunächst ein kleiner Datensatz generiert werden. Für die vollständige Generierung wird die in den Run Settings konfigurierte Anzahl an Cases verwendet.
Das Ergebnis wird als SQL mit den entsprechenden INSERT-Statements ausgegeben. Wahlweise kann ausschließlich das Einfügen der Daten oder zunächst das Leeren und anschließende Neubefüllen der Tabellen vorbereitet werden.
Das erzeugte SQL kann direkt kopiert oder als Datei heruntergeladen werden.
Simple Mode und Expert Mode
Simple Mode
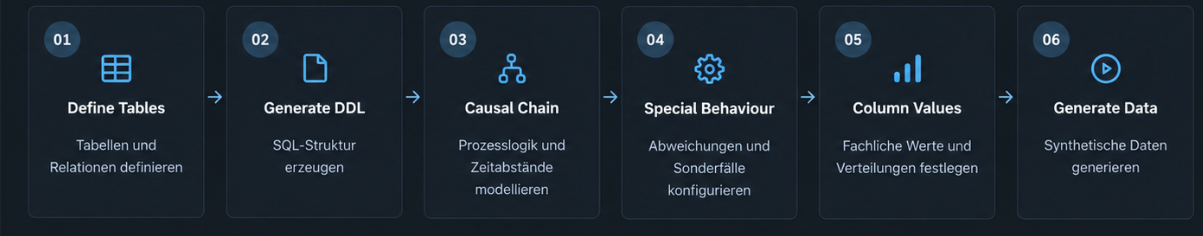
Für die grundlegende Erzeugung synthetischer Prozessdaten reicht der Simple Mode aus.
Der Expert Mode stellt zusätzliche Funktionen für komplexere kausale Effekte zur Verfügung.
Expert Mode
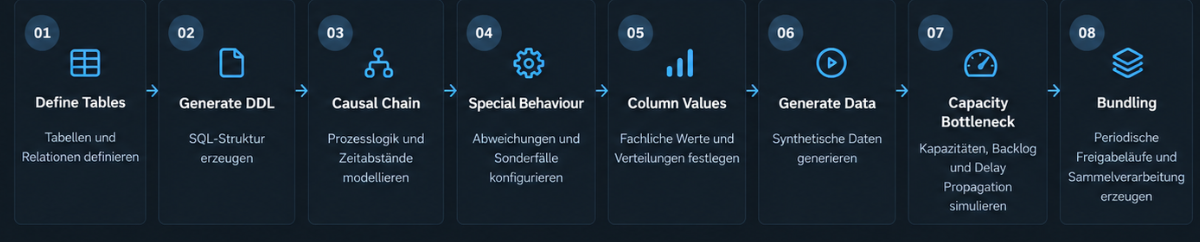
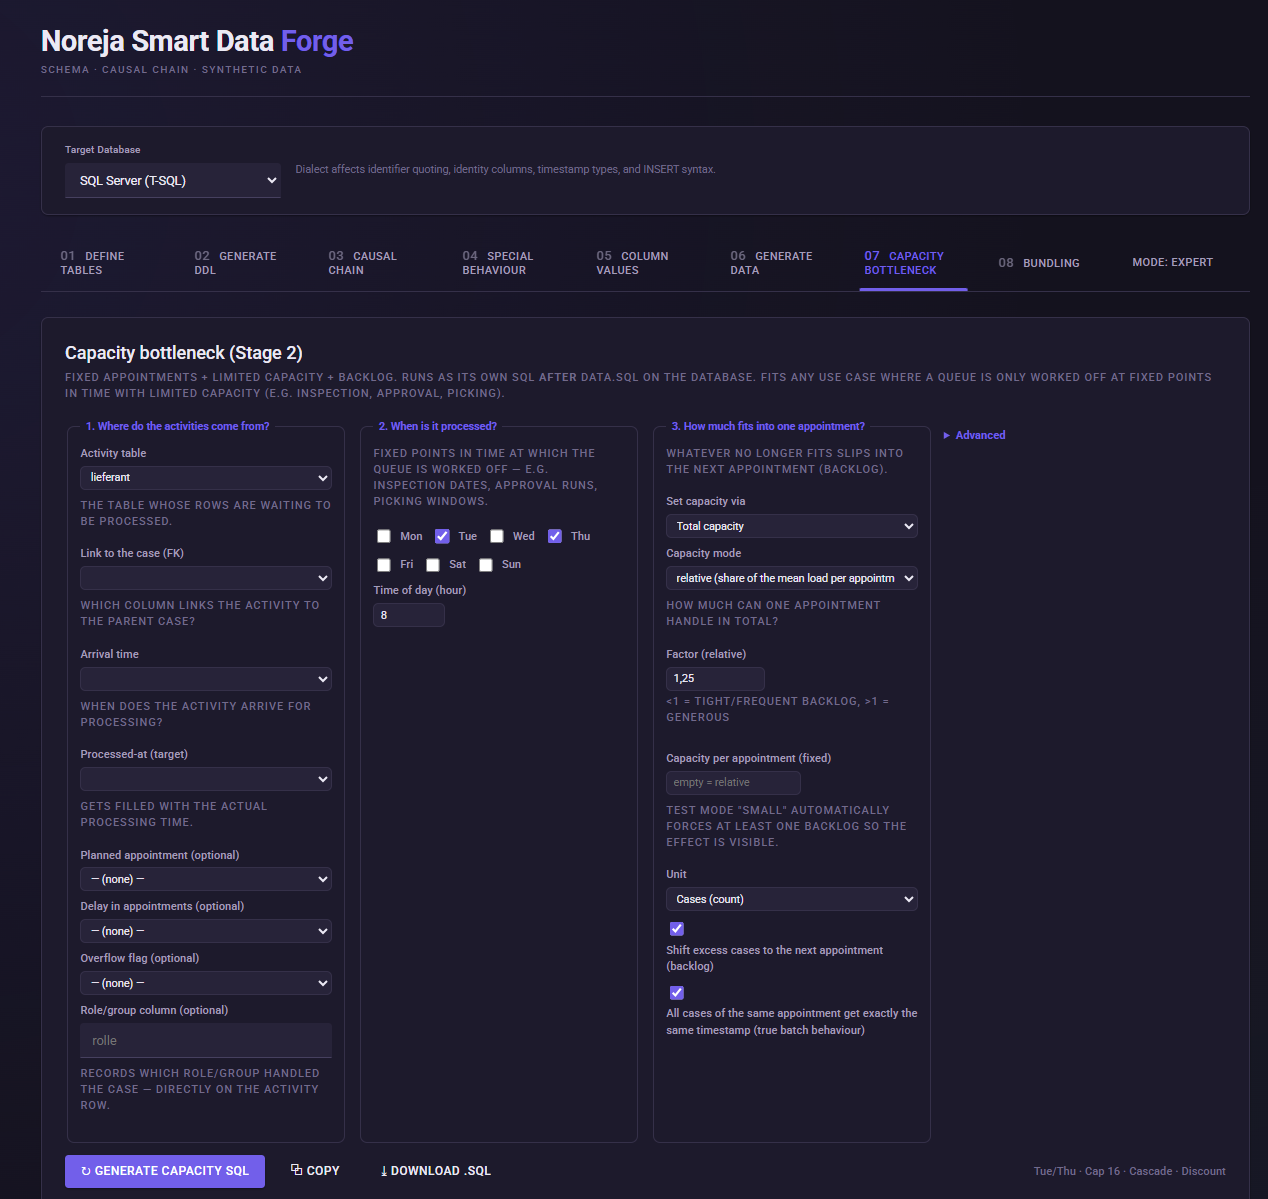
Mit Capacity Bottleneck können Prozessschritte modelliert werden, die nur zu bestimmten Zeitpunkten und mit begrenzter Kapazität bearbeitet werden. Nicht bearbeitete Vorgänge bilden einen Backlog und werden auf einen späteren Bearbeitungszeitpunkt verschoben. Daraus entstehende Verzögerungen können auf nachgelagerte Geschäftsobjekte übertragen werden.
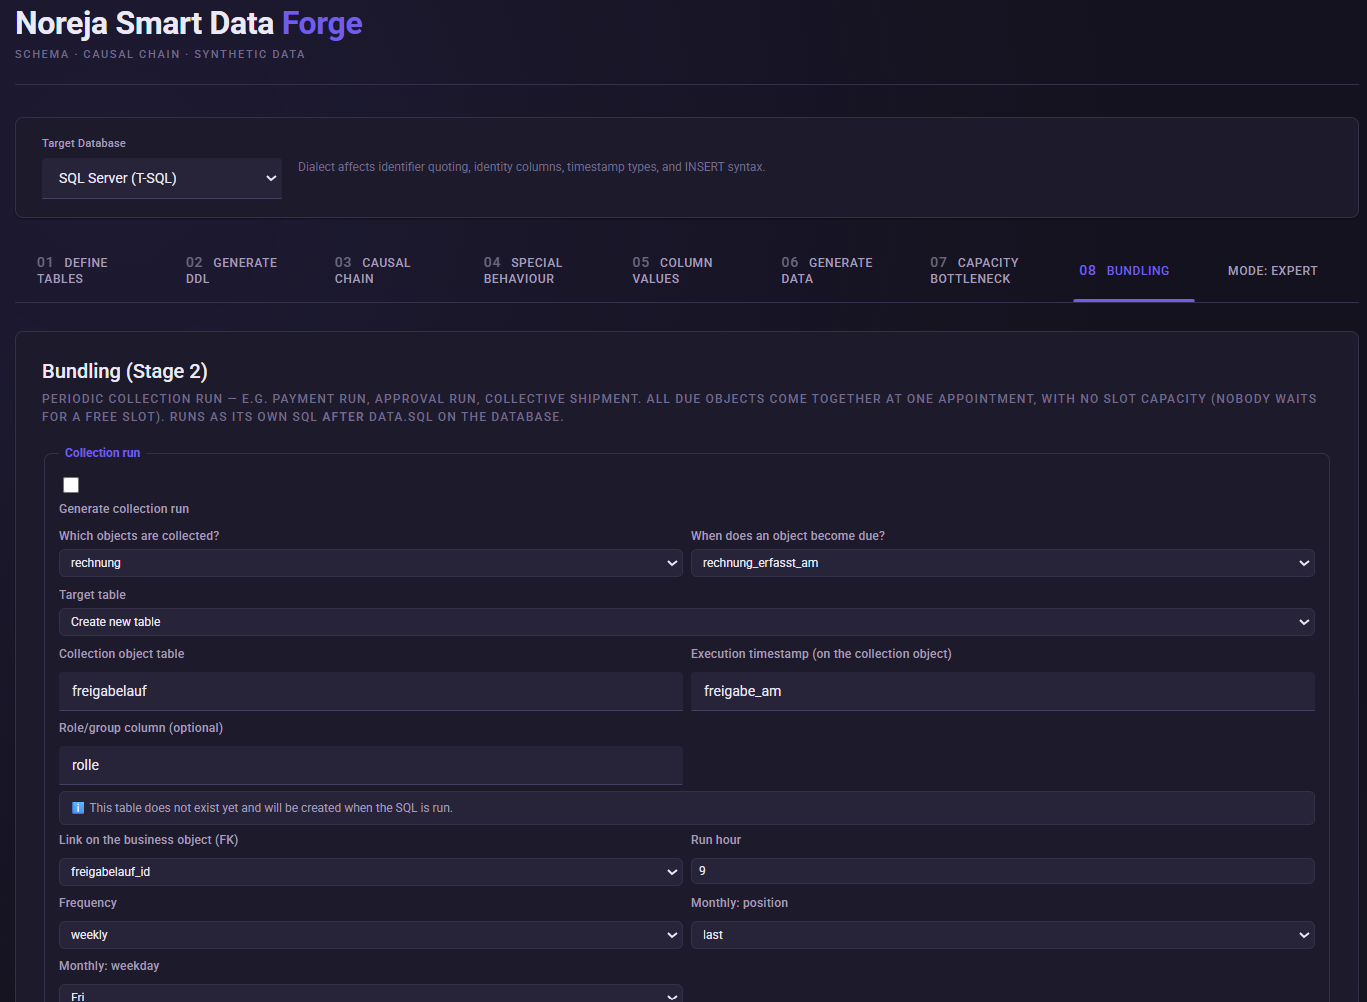
Mit Bundling können Geschäftsobjekte in regelmäßigen Sammelläufen zusammengeführt werden, beispielsweise in einem Zahlungslauf, Freigabelauf oder Sammelversand. Anders als beim Capacity Bottleneck besteht dabei keine begrenzte Kapazität pro Lauf.
Diese Funktionen ermöglichen es, nicht nur einzelne Prozessvarianten, sondern auch strukturelle Ursachen für Wartezeiten und zeitliche Abhängigkeiten synthetisch abzubilden.
Konfiguration speichern und wiederverwenden
Eine erstellte Smart-Data-Forge-Konfiguration kann als JSON-Datei gespeichert und später wieder geladen werden.
Gespeichert werden unter anderem Tabellen und Beziehungen, Prozessstruktur, Abweichungsregeln, Attributkonfigurationen, Run Settings sowie Einstellungen aus dem Expert Mode.
Dadurch können kundenspezifische Prozessmodelle wiederverwendet und iterativ weiterentwickelt werden.
Ergebnis
Das Ergebnis der Smart Data Forge ist ein zusammenhängender synthetischer Datenbestand, bei dem Datenmodell, Prozessstruktur, Zeitverhalten, Attributwerte und definierte Prozessabweichungen aufeinander abgestimmt sind.
Damit können gezielt Datensätze für Demonstrationen, Tests und die Entwicklung kausaler Process-Mining-Analysen erzeugt werden, ohne hierfür produktive Kundendaten verwenden zu müssen.
Wie geht es weiter?
In den nächsten Artikeln wird aus der fachlichen Fragestellung Schritt für Schritt ein analysierbarer Purchase-to-Pay-Datensatz. Dabei siehst du, wie typische P2P-Probleme gezielt im Datenmodell erzeugt werden und später in Noreja analyisiert werden.