Tutorial P2P - Überblick
TL;DR
Ziel: Verstehen, wie aus einer fachlichen Prozessidee ein synthetischer Datensatz entsteht.
Voraussetzungen: Grundkenntnisse in SQL, relationalen Datenmodellen sowie PK-/FK-Beziehungen.
Ergebnis: Du kennst den grundsätzlichen Workflow und kannst mit dem P2P-Beispiel starten.
Von der fachlichen Frage zum Datensatz
Die Noreja Smart Data Forge sollte nicht als reine SQL- oder Zufallsdatengenerierung verstanden werden.
Ausgangspunkt ist eine fachliche Fragestellung.
Fachliche Frage: Gibt es Bestellungen, die den vorgesehenen Freigabeweg umgehen?
Daraus entsteht ein technisches Datenmuster: Eine Bestellung wird erzeugt, obwohl ein erwarteter Freigabeschritt nicht regulär durchlaufen wurde.
Fachliche Frage: Welchen Einfluss hat ein schlecht performender Lieferant auf die Prozessdurchlaufzeit?
Daraus entsteht ein kausaler Zusammenhang: Für einen bestimmten Lieferanten werden gezielt längere Zeitabstände zwischen Prozessschritten erzeugt.
Im späteren P2P-Tutorial werden unter anderem folgende Szenarien aufgebaut:
Maverick Buying → schlechte Lieferantenperformance → Bestelländerung/Rework → Bestellung vor Freigabe → offene Prozesse → Working Capital und Skontoverlust
Der Schwerpunkt liegt dabei nicht nur auf dem technischen Fehlermuster, sondern auf der Frage, welches fachliche Verhalten im erzeugten Datensatz sichtbar werden soll.
Das vereinfachte Purchase 2 Pay - Beispiel
Alle folgenden Artikel verwenden denselben Purchase-to-Pay-Prozess eines Sondermaschinenbauers.
Wir beginnen mit dem Aufbau von:
bestellanforderung
freigabe_a
freigabe_b
bestellung
bestellposition
Damit lassen sich sowohl die Freigabelogik als auch die erste 1:N-Beziehung zwischen Bestellung und Bestellposition erklären.
Anschließend wird eine vorbereitete Basis-Konfiguration importiert. Sie erweitert das Modell um die restlichen P2P-Objekte und vollständigen Attribute, enthält aber zunächst noch keine Special Behaviours und keine Conditional Rules.
Die Tutorial-Konfigurationen
Für die Dokumentation stehen drei aufeinander aufbauende Konfigurationen zur Verfügung:
Config 1 – Basis
Vollständige Simple-Datenstruktur und normale Prozesslogik, aber ohne Fehlermuster und kausale Sonderregeln.
Config 2 – Simple
Referenzstand nach allen Simple-Use-Cases.
Config 3 – Expert
Erweiterung des Simple-Modells um zusätzliche Beschaffungspfade, Capacity Bottleneck, Backlog, Delay Propagation und Bundling.
Der eigentliche Lernpfad besteht darin, die Funktionen selbst aufzubauen. Die Config-Dateien dienen als definierter Ausgangs- bzw. Referenzstand.
Run Settings des Tutorials
Damit das Beispiel übersichtlich und reproduzierbar bleibt, verwenden die Tutorial-Configs:
Database: SQL Server
Number of cases: 500
Start date: 2025-01-01
Span: 90 Tage
Seed: 42
Ein Seed ermöglicht reproduzierbare Zufallswerte; ohne Seed verwendet die Smart Data Forge echte Zufallsziehung für den jeweiligen Lauf. Die entsprechenden Einstellungen befinden sich unter Run settings.
Konfigurationen speichern und laden
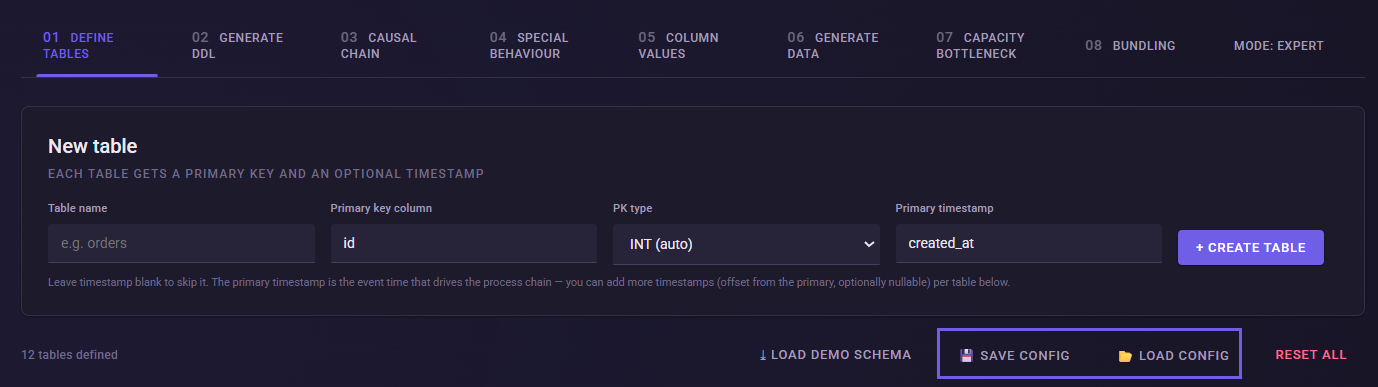
Mit Save config kann der komplette aktuelle Arbeitsstand als JSON-Konfiguration gespeichert werden.
Load config lädt einen solchen Stand wieder vollständig in die Smart Data Forge. Dabei wird der bestehende Arbeitszustand ersetzt und nicht mit ihm zusammengeführt. Die Config enthält unter anderem Tabellen, Slots, Behaviours, Conditional Rules, Column Values, Run Settings und Expert-Konfigurationen.
Im Tutorial ist ein Zwischenspeichern optional. Am Ende des Simple- bzw. Expert-Lernpfads kann der eigene Stand mit der jeweiligen Referenzconfig verglichen werden.
Wie geht es weiter?
Im nächsten Artikel erstellen wir die ersten Tabellen des P2P-Modells selbst und verbinden die Objekte über Foreign Keys.
Dabei geht es noch nicht darum, Prozessfehler zu erzeugen. Zunächst schaffen wir eine nachvollziehbare relationale Grundlage, auf der die späteren Prozessvarianten aufbauen.