Tutorial P2P - kausale Kette
TL;DR
Ziel: Aus den zuvor angelegten Tabellen eine kausale P2P-Prozessstruktur aufbauen. Dabei konfigurieren wir den Freigabeweg und eine echte 1:N-Beziehung zwischen Bestellung und Bestellposition.
Voraussetzungen:bestellanforderung,freigabe_a,freigabe_b,bestellungundbestellpositionsind angelegt.
Ergebnis: Die Smart Data Forge kennt nicht mehr nur die Tabellenbeziehungen, sondern auch die fachliche Reihenfolge, Freigabelogik, Zeitabstände und Kardinalitäten des Prozesses.
Im vorherigen Schritt haben wir definiert, welche Objekte existieren und wie sie relational miteinander verbunden sind.
Das reicht für synthetische Process-Mining-Daten noch nicht aus. Ein Foreign Key sagt beispielsweise aus, dass eine bestellposition zu einer bestellung gehört. Er sagt aber noch nicht:
- wann die Bestellposition entsteht,
- wie viele Positionen eine Bestellung besitzt,
- welche Freigaben vorher notwendig sind,
- oder welche Prozesspfade ein Case durchlaufen kann.
Diese Regeln werden unter 03 Causal Chain definiert.
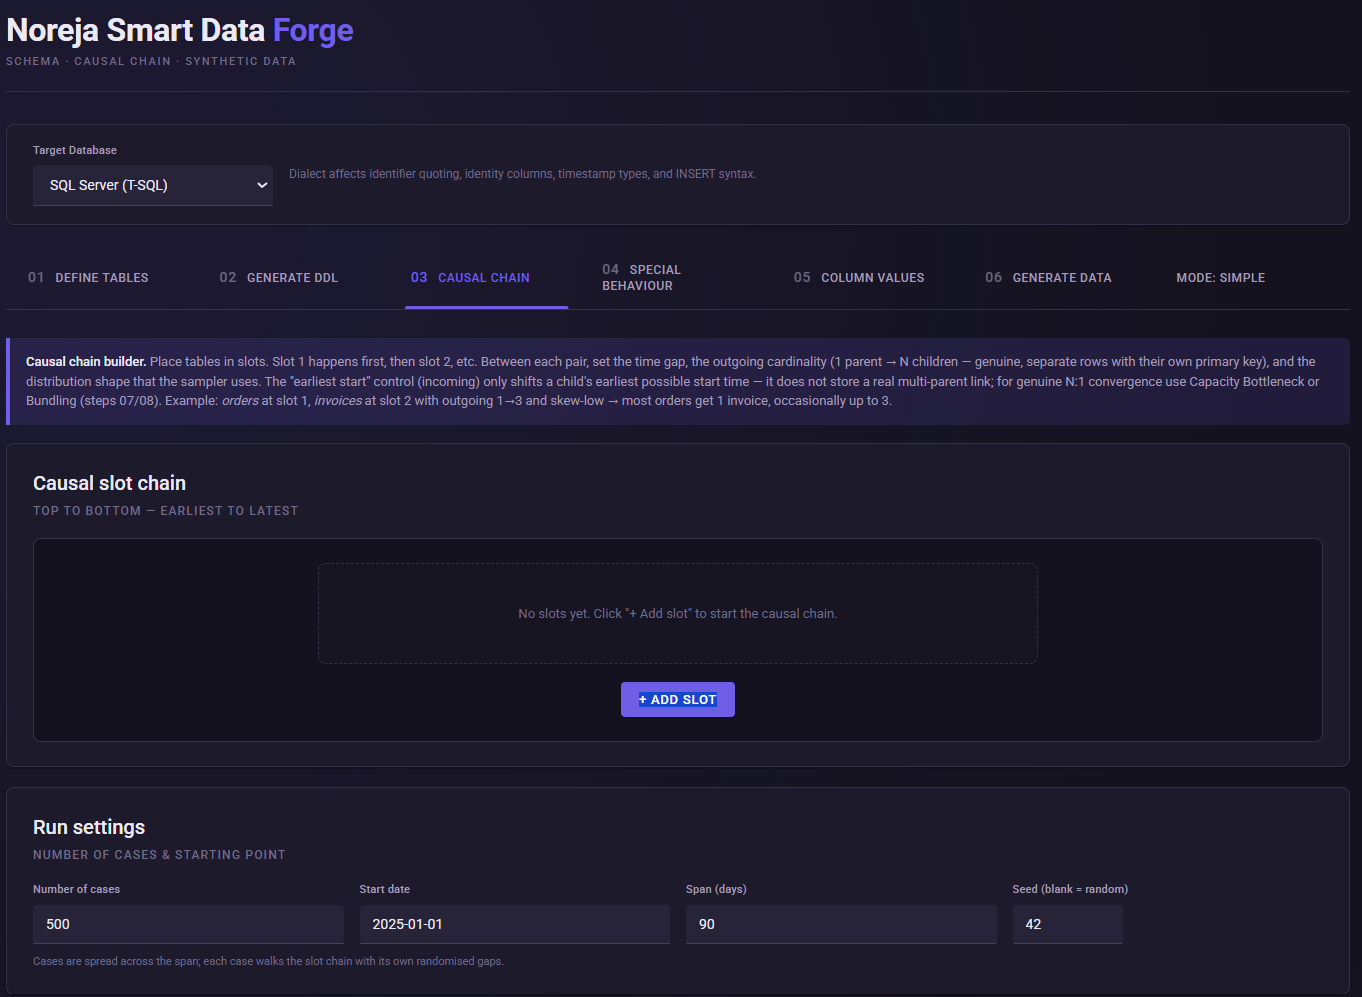
Die Smart Data Forge arbeitet dort mit Slots. Ein Slot repräsentiert die Position eines Objekts innerhalb des kausalen Ablaufs. Neben der Reihenfolge können zwischen den Slots Zeitabstände und Kardinalitäten hinterlegt werden.
1. bestellanforderung als Startpunkt setzen
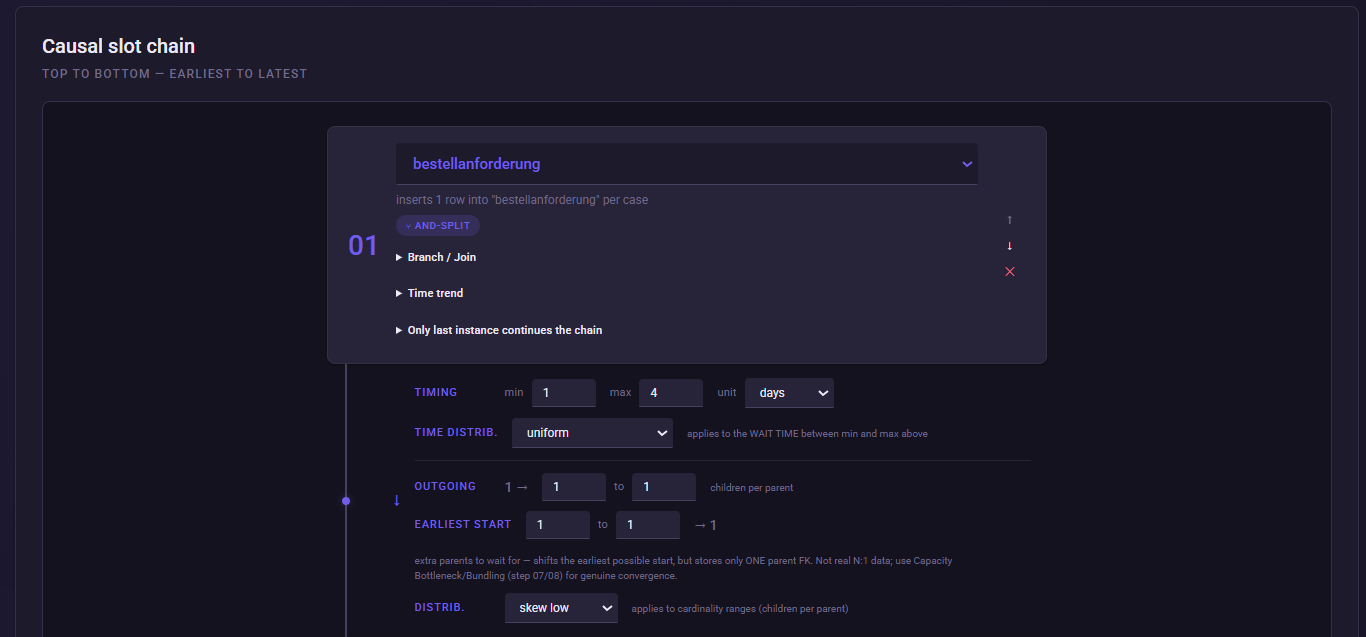
Öffne 03 Causal Chain und füge über + Add slot den ersten Slot hinzu.
Wähle:
bestellanforderung
Die Bestellanforderung ist der Einstiegspunkt unseres P2P-Cases.
Für den Übergang nach der Bestellanforderung verwenden wir dieselben grundlegenden Zeitparameter wie im vollständigen Demo-Set:
| Einstellung | Wert |
|---|---|
| Gap min | 1 |
| Gap max | 4 |
| Unit | days |
| Outgoing min | 1 |
| Outgoing max | 1 |
| Distribution | skew low |
Damit wird jeder Case zunächst mit genau einer Bestellanforderung gestartet. Der folgende Freigabeprozess beginnt typischerweise ein bis vier Tage später.
Das vorhandene P2P-Modell verwendet für die Bestellanforderung ebenfalls einen Abstand von 1–4 Tagen.
2. Den Freigabeweg modellieren
Unser Prozess besitzt nicht nur einen einzelnen Freigabeschritt.
Im vollständigen Beispiel gibt es zwei Freigabeobjekte:
freigabe_a
freigabe_b
Diese werden im regulären Freigabeweg nach der Bestellanforderung ausgeführt und vor der Bestellung wieder zusammengeführt.
Dazu benötigen wir die erweiterten Einstellungen unter Branch / Join.
Die Oberfläche verwendet Parent slot, Branch tag, XOR-Split sowie Join-Einstellungen, um solche Strukturen abzubilden.
freigabe_a hinzufügen
Erstelle einen neuen Slot und wähle: freigabe_a
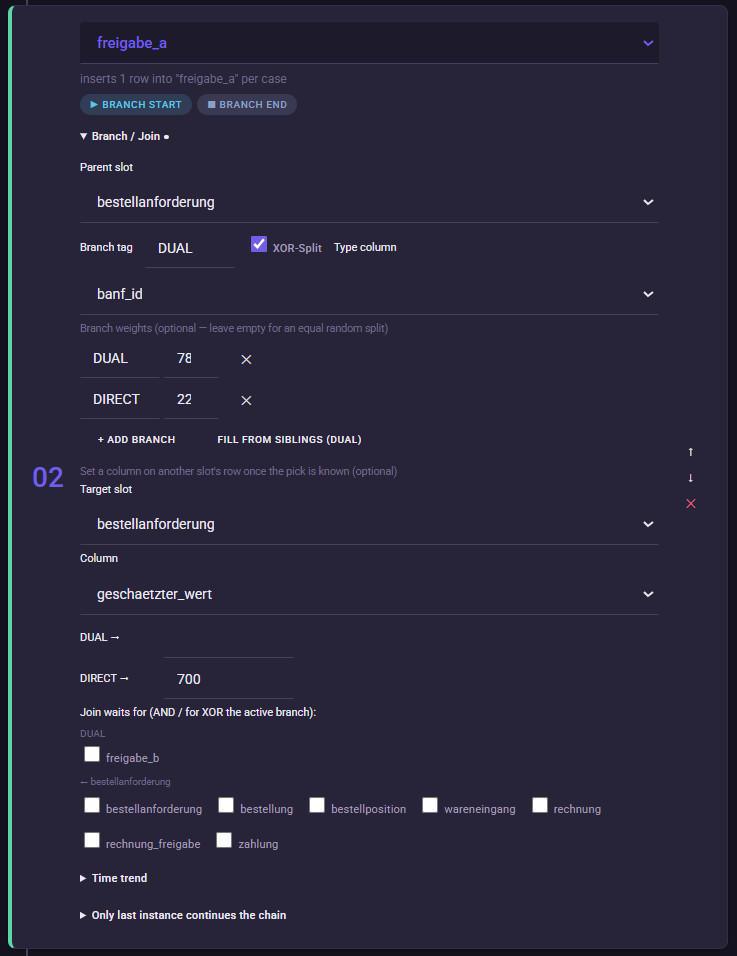
Öffne innerhalb des Slots Branch / Join.
Setze:
Parent slot: bestellanforderung
Branch tag: DUAL
Aktiviere: XOR-Split
Was bedeutet das fachlich?
Die XOR-Entscheidung unterscheidet in unserem Demo-Modell zwei grundsätzliche Fälle:
DUAL: Der reguläre Freigabeweg wird durchlaufen.
DIRECT: Die Bestellung kann ohne diesen Freigabeweg weiterlaufen.
Das vollständige Demo-Modell verwendet dafür eine Gewichtung:
DUAL: 78
DIRECT: 22
Die Smart Data Forge unterstützt gewichtete XOR-Entscheidungen. Ohne Gewichtung würde zufällig gleichverteilt ausgewählt; über die Gewichte lässt sich ein bestimmtes Verhältnis vorgeben.
Konfiguriere daher im XOR-Bereich:
| Branch | Weight |
|---|---|
DUAL | 78 |
DIRECT | 22 |
Der DIRECT-Pfad besitzt in diesem Modell keinen eigenen Freigabe-Slot. Wird DIRECT gewählt, werden die Slots des DUAL-Freigabewegs nicht erzeugt und der Prozess kann anschließend direkt mit der Bestellung fortgesetzt werden.
Diese Struktur ist später die Grundlage für die Unterscheidung zwischen regulärer Direktbeschaffung und einem Maverick-Buying-/Bypass-Szenario. Den eigentlichen unerwünschten Bypass konfigurieren wir erst im Artikel zu Special Behaviour.
3. freigabe_b ergänzen
Füge einen weiteren Slot mit freigabe_b hinzu.
Öffne ebenfalls Branch / Join und setze:
Parent slot: bestellanforderung
Branch tag: DUAL
Damit gehören freigabe_a und freigabe_b zum selben regulären Freigabeweg.
Im bestehenden P2P-Modell besitzen beide Freigaben die Bestellanforderung als Ausgangspunkt und verwenden denselben Branch DUAL.
Für die Zeitabstände verwenden wir die vorhandenen Werte:
freigabe_a Gap: 2–12 Stunden
freigabe_b Gap: 4–24 Stunden
4. Die Freigaben vor der Bestellung zusammenführen
Nun wird die bestellung als nächster Slot angelegt.
Füge einen Slot hinzu und wähle: bestellung
Öffne Branch / Join.
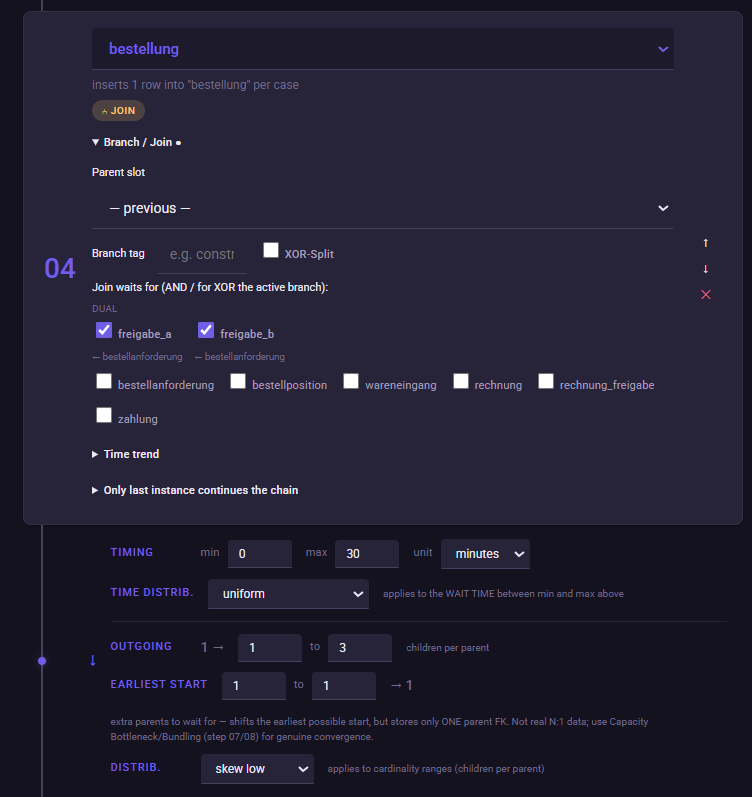
Die Bestellung soll im regulären DUAL-Fall erst entstehen, wenn die erforderlichen Freigaben abgeschlossen sind.
Wähle deshalb freigabe_a und freigabe_b als Join-Quellen aus und verwende einen: AND Join
Der Join wartet im regulären Fall darauf, dass alle erforderlichen Branches beigetragen haben. Ein echter AND-Join wird von der Engine nur fortgesetzt, wenn alle benötigten Branches vorhanden sind.
Setze für den Join gap:
Min: 0
Max: 30
Unit: minutes
Damit entsteht die Bestellung unmittelbar bzw. spätestens ungefähr 30 Minuten nach Abschluss der erforderlichen Freigaben.
Was passiert beim DIRECT-Pfad?
Wurde bei der vorherigen XOR-Entscheidung DIRECT gewählt, gehören die beiden Freigabe-Slots bewusst nicht zu diesem Case.
Die Smart Data Forge behandelt diesen Fall nicht als fehlerhaften unvollständigen AND-Join. Wenn alle entsprechenden Branches aufgrund der XOR-Entscheidung absichtlich entfallen, wird der Join für diesen Case überbrückt und die Prozesskette kann mit der Bestellung fortgesetzt werden.
Damit können reguläre Freigabeprozesse und fachlich vorgesehene Direktbestellungen innerhalb desselben Datensatzes existieren.
5. Die 1:N-Beziehung zur Bestellposition konfigurieren
Nun modellieren wir eine der wichtigsten Strukturen unseres Beispiels.
Eine bestellung kann mehrere bestellposition-Datensätze besitzen.
Füge nach bestellung einen Slot für: bestellposition hinzu.
Die Kardinalität wird am ausgehenden Übergang des Parent-Slots bestellung eingestellt.
Konfiguriere bei bestellung:
| Einstellung | Wert |
|---|---|
| Gap min | 0 |
| Gap max | 30 |
| Unit | minutes |
| Outgoing min | 1 |
| Outgoing max | 3 |
| Distribution | skew low |
Was bedeutet skew low?
Die Kardinalität 1–3 bedeutet zunächst:
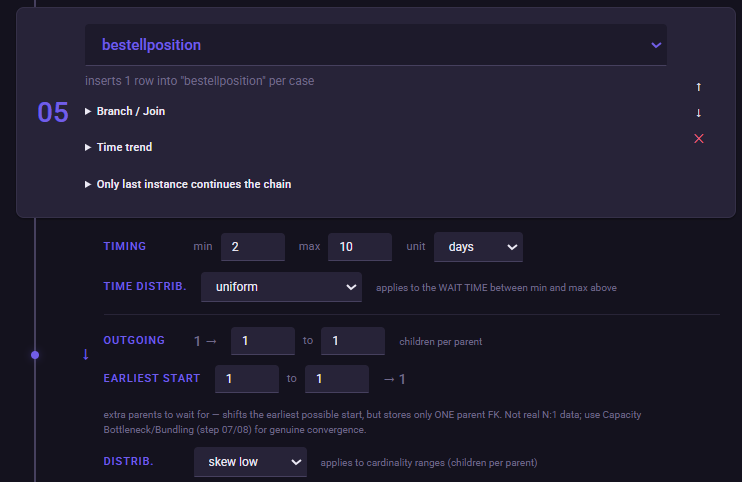
Eine Bestellung erzeugt mindestens eine und maximal drei Bestellpositionen.
Mit skew low sind diese drei Möglichkeiten aber nicht gleich wahrscheinlich.
Die Verteilung ist stark zum unteren Ende verschoben. Dadurch entstehen häufiger Bestellungen mit einer Position und seltener Bestellungen mit der maximalen Anzahl. Die Engine implementiert skew_low ausdrücklich als Verteilung mit starker Bevorzugung niedriger Werte.
Das ist realistischer als eine einfache Gleichverteilung.
Wichtig ist außerdem: Die Smart Data Forge erzeugt bei einem 1:N-Fan-out echte separate Child-Zeilen. Jede Bestellposition besitzt somit ihren eigenen position_id.
Kardinalitätsverteilung und Zeitverteilung nicht verwechseln
Im Slot existieren zwei unterschiedliche Konzepte.
Distribution beeinflusst die Kardinalität – also beispielsweise, ob eher eine, zwei oder drei Bestellpositionen entstehen.
Die Zeitverteilung steuert dagegen, wie der Zeitabstand zwischen zwei Prozessschritten innerhalb des definierten Min-/Max-Bereichs gezogen wird.
Diese beiden Verteilungen erfüllen unterschiedliche Aufgaben. Die aktuelle Engine trennt die Kardinalitätsverteilung ausdrücklich von der Verteilung der Prozesszeit.
Das ist später insbesondere bei langen Durchlaufzeiten und Bottlenecks relevant.
6. Run Settings für das Tutorial setzen
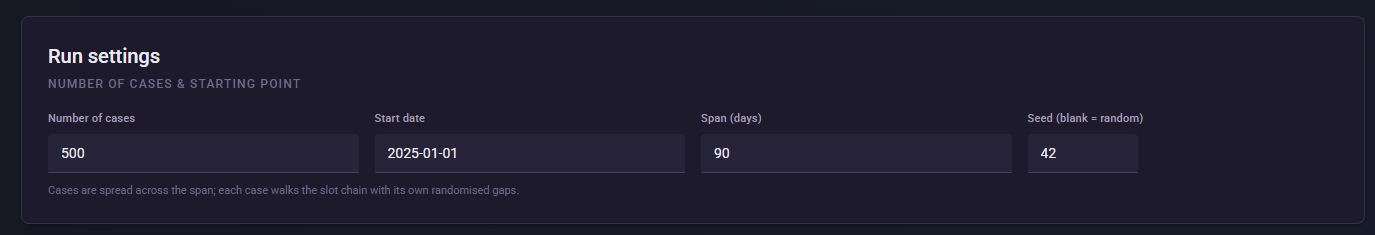
Unterhalb der Causal Chain befindet sich Run settings.
Setze für unser Training:
| Einstellung | Wert |
|---|---|
| Number of cases | 500 |
| Start date | 2025-01-01 |
| Span (days) | 90 |
| Seed | 42 |
Die Cases werden über den angegebenen Zeitraum verteilt. Jeder Case durchläuft anschließend die Prozessstruktur mit den jeweils konfigurierten Zeitabständen.
Der Seed sorgt dafür, dass wir bei wiederholten Läufen reproduzierbare Zufallsentscheidungen erhalten.
Unser Prozessstand
Nach diesem Artikel haben wir vereinfacht folgende Struktur:
bestellanforderung
→ Entscheidung DUAL oder DIRECT
DUAL:
freigabe_a
+freigabe_b
→ AND Join
DIRECT:
Freigabeweg entfällt
→ bestellung
→ bestellposition 1:N, 1–3, skew low
Damit enthält unser Modell bereits drei wichtige Process-Mining-Konzepte:
Verzweigung: Nicht jeder Case muss denselben Pfad durchlaufen.
Synchronisation: Im regulären DUAL-Pfad müssen die benötigten Freigaben abgeschlossen sein.
Fan-out: Aus einer Bestellung können mehrere eigenständige Bestellpositionen entstehen.
Noch keine Prozessfehler
Wichtig: Die bisher erzeugten Varianten sind zunächst Teil des regulären Prozessmodells.
Ein DIRECT-Pfad ist nicht automatisch Maverick Buying.
Erst später konfigurieren wir gezielt Fälle, bei denen ein Case aufgrund bestimmter fachlicher Eigenschaften einen eigentlich vorgesehenen Freigabeweg unerwünscht umgeht.
Das geschieht unter Special Behaviour mit dem Team Bypass.
Diese Unterscheidung ist wichtig:
Prozessvariante bedeutet, dass ein bestimmter Weg grundsätzlich Teil des Modells ist.
Prozessabweichung bedeutet, dass ein Case gezielt von dem für ihn erwarteten Verhalten abweicht.
Typische Fehler / darauf achten
Die Kardinalität wird am Parent eingestellt.
Die 1–3 Bestellpositionen werden am ausgehenden Übergang von bestellung konfiguriert – nicht erst auf bestellposition.
skew low betrifft hier die Anzahl der Child-Zeilen.
Es ist nicht automatisch eine Einstellung für die Zeitverteilung.
Ein AND-Join ist eine echte Synchronisation.
Wenn ein erforderlicher Branch tatsächlich fehlen sollte, kann der Join nicht einfach mit dem verbleibenden Branch fortgesetzt werden. Die Engine behandelt einen unvollständigen echten AND-Join als Abbruch der Kette.
DIRECT ist noch kein Maverick Buying.
Die reguläre Prozessstruktur und ein absichtlich erzeugter Compliance-Verstoß sollten fachlich getrennt betrachtet werden.
Nächster Schritt: auf das vollständige Basismodell wechseln
Bis hierhin haben wir die wichtigsten Modellierungsprinzipien bewusst selbst aufgebaut.
Für die folgenden fachlichen Use Cases benötigen wir jedoch den vollständigen P2P-Datensatz mit Lieferanten, Materialien, Wareneingängen, Rechnungen, Rechnungsfreigaben, Zahlungen und weiteren Attributen.
Im nächsten Schritt laden wir deshalb:
p2p-01-basis-config.json
Die Basis-Config ersetzt unseren bisherigen Übungsstand und enthält das vollständige Simple-P2P-Modell, jedoch noch ohne Special Behaviours und ohne Conditional Rules.
Ab diesem definierten Ausgangspunkt bauen wir anschließend die fachlichen Auffälligkeiten Schritt für Schritt selbst auf.
[SCREENSHOT: Load config mit ausgewählter p2p-01-basis-config.json]
Weiter: Tutorial P2P vollständiges Basismodell laden und verstehen