Der Ursprung von Causal Process Mining
Der Ansatz von Noreja geht auf die Forschung seiner Gründer zurück. Das Paper Causal Process Mining from Relational Databases with Domain Knowledge von Philipp Waibel, Lukas Pfahlsberger, Kate Revoredo und Jan Mendling (Wirtschaftsuniversität Wien und Humboldt-Universität zu Berlin) hat Causal Process Mining eingeführt. Diese Seite fasst seine Ideen zusammen und zeigt, wo du ihnen heute in Noreja begegnest.
Warum klassisches Process Mining an Grenzen stößt
Die meisten Process-Mining-Werkzeuge bauen auf zwei Dingen auf: einem Event-Log mit einer Fall-ID für jedes Ereignis und Directly-Follows-Beziehungen, die jedes Ereignis mit dem Ereignis verbinden, das im selben Fall als Nächstes stattfand. Bei einfachen Prozessen funktioniert das gut. Es scheitert, wenn die Geschäftsobjekte hinter den Ereignissen in 1:N- oder N:M-Beziehungen zueinander stehen, wie es in einem ERP-System meist der Fall ist.
Das Paper verwendet den Order-to-Cash-Prozess eines europäischen Lebensmittelherstellers. Eine Bestellung eines Supermarkts wird in mehrere Positionen aufgeteilt; jede Position wird im Lager kommissioniert, verpackt und geliefert, und die Bestellung wird in Rechnung gestellt und bezahlt. Hat eine Bestellung drei Positionen, zeichnet das Event-Log die Kommissionierschritte dieser Positionen nacheinander auf. Ein Directly-Follows-Algorithmus schließt daraus, dass Kommissionieren auf Kommissionieren folgt oder dass das Anlegen einer Position auf das Kommissionieren folgt. Beides stimmt nicht: Beides kommt daher, dass die Bestellung mehrere Positionen hat.
Das Ergebnis sind Beziehungen, die es nicht gibt (Scheinbeziehungen), Selbstschleifen und Rücksprünge. Zusammen erzeugen sie die bekannten „Spaghetti-Modelle“, und sie verfälschen Leistungskennzahlen, zum Beispiel die Durchlaufzeit zwischen zwei Aktivitäten.
Beobachten reicht nicht
Das Paper bezieht sich auf die Arbeiten von Judea Pearl zur Kausalität: Zusammenhänge in Daten allein können dir nicht sagen, welches Ereignis welches verursacht hat. Eine Abfolge „Bestellung, Kommissionierung, Rechnung“ passt gleich gut zu mehreren Erklärungen, egal wie oft sie beobachtet wird. Im Prozess des Lebensmittelherstellers wird die Rechnung durch das Ende der Kommissionierung ausgelöst, aber erst am nächsten Werktag nach der Lieferung ausgestellt. Ein Algorithmus, der nur auf die Reihenfolge der Ereignisse schaut, kann das nicht wissen.
Der Ausweg ist, die Daten mit Wissen über Ursache und Wirkung zu verbinden. Viel von diesem Wissen steckt schon im Quellsystem: Die Fremdschlüssel einer relationalen Datenbank sagen, zu welcher Bestellung eine Position gehört und für welche Position eine Lieferung ist. Was fehlt, können Menschen ergänzen, die den Prozess kennen.
Vier Anforderungen
Daraus leitet das Paper vier Anforderungen an einen Process-Mining-Ansatz ab:
- Kausale Eingangsdaten: die kausale Struktur der Quelldatenbank erhalten, statt sie zu einem Event-Log abzuflachen.
- Domänenwissen: Expertinnen und Experten Wissen über Ursache und Wirkung ergänzen lassen, das die Daten nicht zeigen können, und die Daten damit vergleichen.
- Kardinalitäten: festhalten, wie viele Ereignisse eines Typs mit einem Ereignis eines anderen Typs verbunden sind, damit Aufteilungen, Zusammenführungen und Bündelungen richtig dargestellt werden.
- Aggregation: den Prozess sowohl im Detail, für einen einzelnen Fall, als auch zusammengefasst zeigen, bis hin zum gesamten Prozessmodell.
Wie Causal Process Mining funktioniert
Causal Process Mining überspringt das Event-Log. Es liest die relationalen Daten direkt und wandelt sie in Graphen um, die in einer Graphdatenbank gespeichert werden:
- Tabellen auswählen: die Tabellen wählen, die die Ereignisse des Prozesses enthalten, verbunden über ihre Fremdschlüssel.
- Causal Process Template festlegen: Eine Expertin oder ein Experte legt fest, welche Ereignisse welcher Tabelle welche anderen verursachen. Das Template kann dem Datenbankschema folgen oder davon abweichen, wo der Prozess anders funktioniert.
- Causal Event Graphs aufbauen: Jede Menge verbundener Zeilen wird zu einem Graphen aus Ereignissen und ihren kausalen Beziehungen. Gehört ein Ereignis zu mehreren solchen Graphen, zum Beispiel eine Lieferung für zwei Bestellungen, werden die Graphen verbunden, und das gemeinsame Ereignis ist ein Bündelungsereignis.
- Zusammenfassen: Die Causal Event Graphs werden zu aggregierten Graphen zusammengefasst, die zählen, wie oft jeder Ereignistyp und jede Beziehung vorkam, mit ihren Kardinalitäten.
- Analysieren: Die Graphen werden als Prozessgraphen angezeigt, Kennzahlen werden aus ihnen berechnet, und Verstöße werden erkannt.
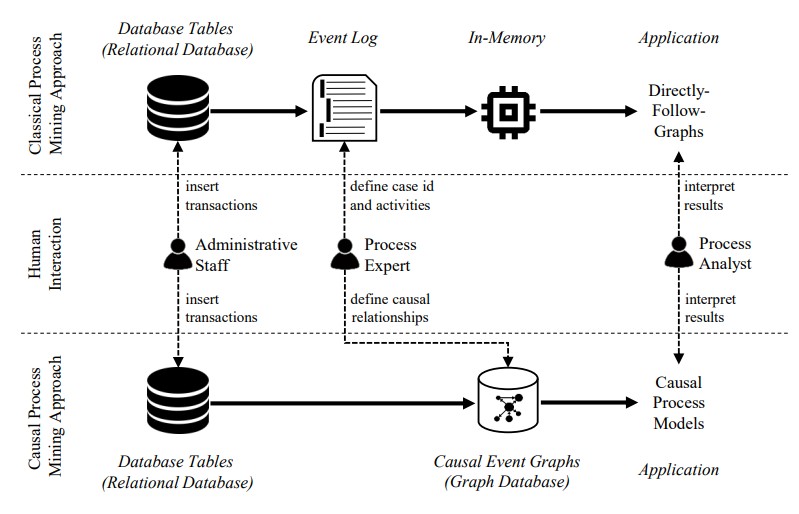
Weil die Daten nicht abgeflacht werden, bleiben Kardinalitäten und kausale Beziehungen erhalten. Die Graphen sind nicht an eine vorab festgelegte Fall-ID gebunden, und mehrere Anwendungen können dieselben Daten abfragen.
Drei Aggregationsebenen
- Ebene 1: ein aggregierter Graph für jeden Causal Event Graph, eine allgemeinere Sicht auf einen einzelnen Fall.
- Ebene 2: ein aggregierter Graph für alle Fälle mit derselben Struktur.
- Ebene 3: ein aggregierter Graph für alle Fälle, das Prozessmodell.
Jede Beziehung trägt ihre Anzahl und ihre Kardinalitäten als Minimum und Maximum auf beiden Seiten, zum Beispiel 1..1 : 1..3, wenn eine Bestellung zu einer bis drei Positionen führt.
Verstöße statt zusätzlicher Beziehungen
Fand ein Ereignis vor dem Ereignis statt, das es verursacht, ist die kausale Beziehung zeitlich verletzt. Solche zeitlichen Verstöße werden festgehalten, statt dem Modell neue Beziehungen hinzuzufügen. Eine spätere Änderung an einer Bestellung zum Beispiel erscheint als Verstoß und fügt keinen Rücksprung hinzu, der das Modell komplexer macht.
Die Evaluation
Der Ansatz wurde mit den echten Daten des Lebensmittelherstellers getestet: rund 70.000 Bestellungen mit mehr als 8,5 Millionen Ereignissen aus neun Tabellen eines ERP-Systems auf Microsoft SQL Server, ohne vorherige Datenbereinigung. Die Ergebnisse wurden mit zwei etablierten Werkzeugen verglichen: einem Directly-Follows-Graphen aus PM4Py und einem BPMN-Modell aus Split Miner 2.0.
- Directly-Follows-Graph: voller Selbstschleifen und Beziehungen, die der Datenbankstruktur widersprechen, zum Beispiel von der Kommissionierung zurück zur Lieferungsvorbereitung.
- BPMN-Modell: manche Reihenfolgen richtig, andere aber umgekehrt oder als parallel dargestellt, obwohl sie nacheinander stattfinden, und wieder viele Selbstschleifen.
- Causal Process Mining: keine Selbstschleifen und keine dieser Scheinbeziehungen, und die Reihenfolge der Aktivitäten bleibt erhalten.
Um die Konformität mit der erwarteten kausalen Reihenfolge zu vergleichen, zählt das Paper alle unerwarteten Beziehungen und zeitlichen Verstöße zusammen. Der Directly-Follows-Graph kam auf 1.153.710, das kausale Modell auf 165.124. Selbst ohne die beiden Aktivitäten, die den größten Teil des Werts des Directly-Follows-Graphen verursachten, blieb er bei 687.053.
Wo du diese Ideen in Noreja findest
Der Prototyp des Papers wurde als Teil des Werkzeugs Noreja gebaut, und seine Konzepte haben heute Produktnamen:
Im Paper | In Noreja |
|---|---|
Ausgewählte Tabellen, über Fremdschlüssel verbunden | Eine Entität mit ihren Objekten und Datenbeziehungen |
Kausales Wissen der Expertin oder des Experten | Die erwartete Reihenfolge einer Perspektive |
Causal Event Graph | Fallinstanz |
Aggregationsebenen 1, 2 und 3 | Fallmodell, Variante und Prozessmodell |
Zeitlicher Verstoß | Reihenfolgefehler, eines der Prozessmuster |
Siehe Entitäten erklärt, Die erwartete Reihenfolge: Hypothese der Perspektive, Abkürzungen und Rücksprünge, Prozessmodelle und Ebenen: Geschäftsfall, Variante, Prozessmodell und Prozessmuster: Reihenfolgefehler, Ignorieren, Nachbearbeitung und erlaubte Abweichungen.
Das Paper lesen
Das vollständige Paper, mit den formalen Definitionen, den Abbildungen und der kompletten Evaluation, ist auf arXiv verfügbar (auf Englisch): Causal Process Mining from Relational Databases with Domain Knowledge.